800GB 테이블 조회 12초에서 0.4초가 된 이유?
최근 회사에서 업무를 하던 중, 원본 DB에서 DT로 데이터를 가져오지 못해 원본 DB를 직접 조회해야 하는 상황이 발생했다.
그동안 우리가 주로 사용하던 RDB 테이블은 데이터가 많아봐야 수십 GB 수준이었다. 물론 이 정도 크기의 테이블도 조회가 오래 걸리는 경우는 있었지만, 800GB 정도 되는 테이블을 직접 조회해본 것은 이번이 처음이었다.
이전까지는 DT로 가져온 테이블을 대상으로 작업하는 경우가 많았고, 그 테이블에는 별도의 인덱스를 걸지 않은 상태에서 조회하는 경우도 많았다.
그러다 보니 인덱스가 중요하다는 것은 알고 있었지만, 실제로 인덱스 하나 때문에 조회 성능이 얼마나 크게 달라질 수 있는지 체감해본 적은 없었다.
그런데 이번에 인덱스의 중요성을 제대로 경험했다.
처음 작성한 쿼리
처음 작성한 쿼리는 실행하는 데 수십 초가 걸렸다.
사실상 기록할 필요도 없을 정도로 느린 조회 속도였다.
문제는 원본 데이터가 실제 서비스에서 사용 중인 테이블이었기 때문에, 내가 마음대로 인덱스를 추가하거나 수정할 수 없었다는 점이다.
그래서 우선 현재 테이블에 어떤 인덱스가 존재하는지 확인해봤다.
그 과정에서 내가 사용할 수 있을 것 같은 복합 인덱스 하나를 발견했다.
예를 들어 해당 인덱스가 다음과 같이 구성되어 있다고 가정해보자.
1
(A, B, C)
여기서 문제는 A 컬럼이었다.
A는 특정 구분 코드였고, 내가 원하는 조회는 특정 구분 코드 하나만 가져오는 것이 아니라 A 전체를 대상으로 데이터를 조회하는 상황이었다.
그래서 두 가지 경우를 테스트해보기로 했다.
A,B,C를 모두 조건에 넣어서 조회- 실제로 필요하다고 생각했던
B,C만 조건에 넣어서 조회
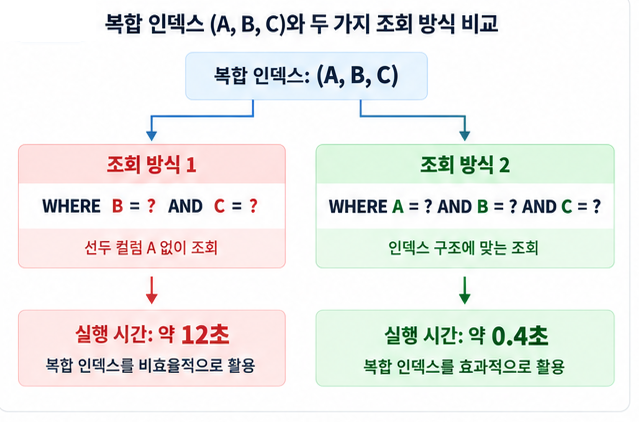
첫 번째 테스트: B, C만 조건으로 조회
먼저 내가 실제로 필요한 조건만 넣어봤다.
1
2
3
4
SELECT *
FROM TABLE
WHERE B = ?
  AND C = ?;
결과는 약 12초.
이걸 보고 가장 먼저 든 생각은 이거였다.
뭐야… 왜 이렇게 오래 걸리지? 이거 인덱스를 제대로 타는 건가?
처음에는 B, C 모두 복합 인덱스에 포함되어 있으니 어느 정도 인덱스를 활용할 것이라고 생각했다.
하지만 결과는 기대와 달랐다.
두 번째 테스트: A, B, C를 모두 조건으로 조회
이번에는 복합 인덱스에 포함된 컬럼을 모두 조건에 넣었다.
1
2
3
4
5
SELECT *
FROM TABLE
WHERE A = ?
  AND B = ?
  AND C = ?;
그리고 결과를 확인했다.
1
약 0.4초
진짜 처음에는 잘못 본 줄 알았다.
뭐야 이거? DT로 가져온 데이터 조회했던 것보다 빠른데?
실행 시간은 약 0.4초 수준이었다.
12초와 0.4초.
차이가 너무 커서 오히려 당황스러울 정도였다.
물론 이 결과가 800GB의 데이터를 0.4초 만에 전부 읽었다는 의미는 아니다.
오히려 반대다.
DB가 800GB 전체를 읽지 않고, 인덱스를 이용해 원하는 데이터가 있는 위치를 빠르게 찾아냈기 때문에 가능한 결과였다.
그 중심에 있는 것이 바로 인덱스(Index) 다.
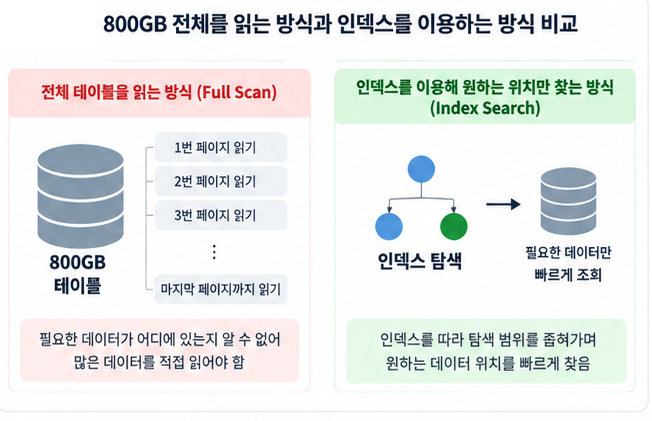
그렇다면 인덱스는 어떻게 데이터를 찾을까?
RDB에서 가장 많이 사용하는 인덱스 구조 중 하나가 B-Tree다.
인덱스가 없다면 DB는 원하는 데이터가 어디에 있는지 알 수 없다.
예를 들어 다음 데이터를 찾는다고 해보자.
1
2
3
SELECT *
FROM USERS
WHERE USER_ID = 5000;
USER_ID에 사용할 수 있는 인덱스가 없다면 DB는 많은 데이터를 직접 확인해야 할 수 있다.
개념적으로 보면 다음과 비슷하다.
1
2
3
4
5
6
7
8
9
10
11
12
1번 데이터 확인
→ USER_ID = 100

2번 데이터 확인
→ USER_ID = 300

3번 데이터 확인
→ USER_ID = 1000

...

USER_ID = 5000 발견
데이터가 적을 때는 큰 문제가 되지 않는다.
하지만 데이터가 수천만 건, 수억 건으로 증가하면 DB가 읽어야 하는 데이터 양도 증가한다.
반면 B-Tree 인덱스가 존재하면 DB는 모든 데이터를 처음부터 확인하지 않는다.
정렬된 인덱스 구조를 따라가면서 탐색해야 할 범위를 계속 줄여나간다.
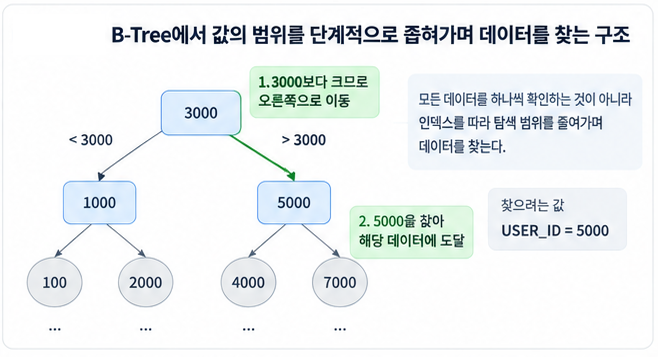
예를 들어 다음과 같이 생각할 수 있다.
1
2
3
4
5
6
7
찾으려는 값: 5000

              [3000]
             /      \
         < 3000      > 3000
                       |
                    [5000]
실제 B-Tree는 이것보다 훨씬 복잡하고 하나의 노드에 여러 개의 값을 가질 수 있지만, 핵심은 같다.
모든 데이터를 하나씩 확인하는 것이 아니라, 인덱스를 따라 필요한 범위로 이동한다.
그래서 데이터가 많아지더라도 원하는 위치까지 도달하는 비용을 크게 줄일 수 있다.
복합 인덱스에서는 컬럼 순서가 중요하다
여기서 이번 경험과 직접적으로 연결되는 부분이 나온다.
복합 인덱스가 다음과 같이 존재한다고 해보자.
1
(A, B, C)
이 인덱스는 단순히 A, B, C 세 컬럼을 각각 따로 가지고 있는 것이 아니다.
개념적으로 다음 순서로 정렬되어 있다.
1
2
3
A
 └── B
      └── C
즉 먼저 A를 기준으로 정렬되고, 같은 A 안에서는 B를 기준으로 정렬되고, 같은 A, B 안에서는 C를 기준으로 정렬된다.
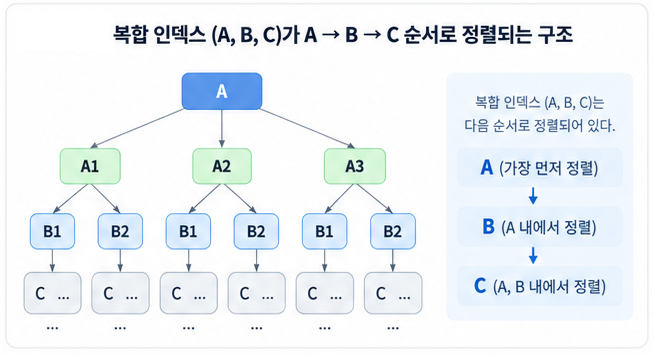
그래서 다음과 같은 조건은 인덱스를 활용하기 좋다.
1
WHERE A = ?
1
2
WHERE A = ?
  AND B = ?
1
2
3
WHERE A = ?
  AND B = ?
  AND C = ?
반면 다음과 같은 조건은 상황이 달라진다.
1
2
WHERE B = ?
  AND C = ?
인덱스의 시작점인 A 조건이 없기 때문이다.
이를 흔히 Leftmost Prefix, 또는 복합 인덱스의 선두 컬럼 규칙이라고 설명한다.
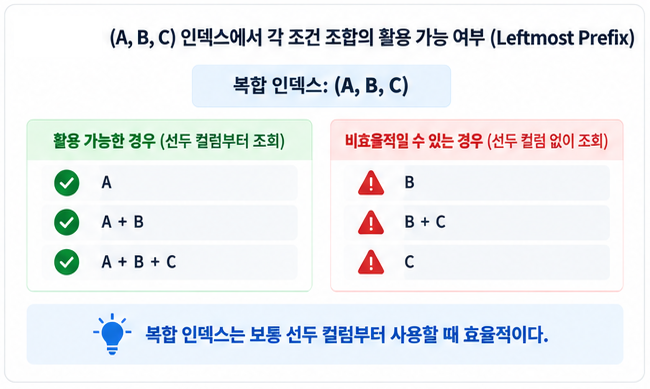
간단하게 표현하면 다음과 같다.
1
2
3
4
5
6
7
8
9
INDEX (A, B, C)

A             → 활용 가능
A + B         → 활용 가능
A + B + C     → 활용 가능

B             → 비효율적일 수 있음
B + C         → 비효율적일 수 있음
C             → 비효율적일 수 있음
물론 실제로 인덱스를 사용할지 여부는 DBMS, 통계 정보, 데이터 분포, 옵티마이저 판단 등에 따라 달라질 수 있다.
하지만 복합 인덱스를 이해할 때는 “컬럼 순서가 중요하다”는 점을 반드시 알고 있어야 한다.
그래서 12초와 0.4초의 차이가 발생했다
다시 내가 테스트했던 상황으로 돌아가보자.
복합 인덱스는 다음과 같았다.
1
(A, B, C)
그리고 두 가지 쿼리를 테스트했다.
B, C만 조건으로 사용
1
2
WHERE B = ?
  AND C = ?
약 12초
A, B, C 모두 조건으로 사용
1
2
3
WHERE A = ?
  AND B = ?
  AND C = ?
약 0.4초
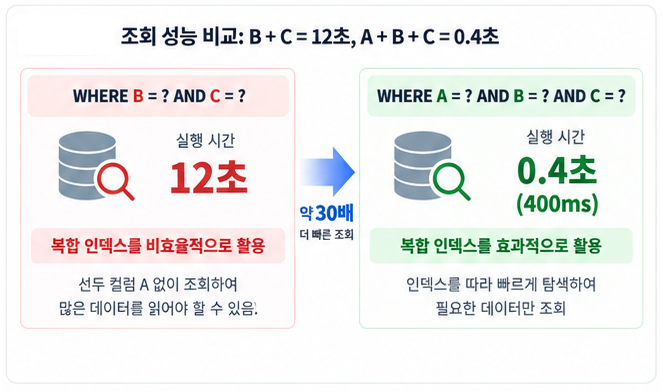
단순히 조건 하나를 추가했을 뿐인데 왜 이렇게 큰 차이가 발생했을까?
첫 번째 쿼리는 복합 인덱스의 시작 컬럼인 A가 없었기 때문에, 인덱스를 효율적으로 활용하지 못했을 가능성이 있다.
반면 두 번째 쿼리는 A → B → C 순서로 인덱스를 따라가면서 조회 범위를 빠르게 좁힐 수 있었다.
즉 중요한 것은 테이블 전체 크기가 800GB라는 사실이 아니었다.
DB가 실제로 몇 GB를 읽었느냐, 몇 개의 페이지를 확인했느냐, 그리고 원하는 데이터를 찾기 위해 얼마나 많은 탐색을 수행했느냐가 더 중요했다.
800GB 테이블이라고 무조건 느린 것은 아니다
이번 경험에서 가장 크게 느낀 부분이다.
처음에는 자연스럽게 이런 생각을 했다.
1
800GB짜리 테이블이니까 당연히 느리겠지.
하지만 실제로는 그렇지 않았다.
800GB 테이블이라고 해도 인덱스를 통해 원하는 데이터를 바로 찾을 수 있다면 매우 빠르게 조회할 수 있다.
반대로 수십 GB 정도의 테이블이라도 매번 많은 데이터를 읽어야 한다면 충분히 느릴 수 있다.
결국 중요한 것은 다음이다.
테이블이 얼마나 큰가보다 DB가 원하는 결과를 찾기 위해 실제로 얼마나 많은 데이터를 읽어야 하는가가 중요하다.
이번 경험 이후 달라진 점
이번 경험 전까지는 쿼리를 작성할 때 주로 다음과 같이 생각했다.
1
어떤 조건이 필요한가?
하지만 이제는 한 가지를 더 생각하게 되었다.
1
현재 어떤 인덱스가 존재하는가?
그리고 그 다음에는 자연스럽게 다음 질문까지 이어진다.
1
2
3
4
5
6
7
이 인덱스의 컬럼 순서는 어떻게 되어 있는가?

내 WHERE 조건이 이 인덱스를 제대로 활용할 수 있는가?

이 조건으로 조회했을 때 후보 데이터가 얼마나 줄어드는가?

실제로 실행 계획에서는 어떤 방식으로 데이터를 읽고 있는가?
가능하다면 EXPLAIN, EXPLAIN ANALYZE 등을 통해 실제 실행 계획까지 확인하는 것이 좋다.
인덱스를 공부할 때 흔히 듣는 말이 있다.
인덱스를 사용하면 조회가 빨라진다.
틀린 말은 아니다.
하지만 이번 경험 이후에는 조금 다르게 이해하게 되었다.
인덱스는 DB가 필요 없는 데이터를 읽지 않도록 만들어주는 탐색 구조다.
그리고 대용량 데이터에서는 “얼마나 빨리 읽는가”보다 “얼마나 적게 읽는가”가 훨씬 중요할 수 있다.
이번 800GB 테이블 조회를 통해 “인덱스가 중요하다”는 말을 단순히 알고 있는 것과, 실제로 체감하는 것은 완전히 다르다는 것을 알게 되었다.